Cloudflare cf CLI 使用指南:如何上手,何时迁移 Wrangler
Cloudflare cf CLI 怎么安装,如何预览 DNS、D1 和缓存请求?已有 Wrangler 项目该不该迁移?结合命令示例,说明配置、权限与 CI 部署中需要留意的差异。
约三千字·读约九分钟 · English
用 Wrangler 部署 Worker,去 Dashboard 改 DNS,再查 API 文档写个清缓存的脚本。Cloudflare 用户大概都熟悉这种来回切换。新的 cf CLI 把这些操作放到了同一个命令行里,也能开发和部署 Workers 项目。
我建议先拿它查资源、预览请求。新 Worker 可以开一个独立项目试用;已经稳定运行的 Wrangler 项目,先把迁移结果看明白,再改部署命令。cf 还在公开 Beta,配置格式和构建产物没有定型,暂时没必要急着把所有项目搬过去。
图 1:Cloudflare 的 cf CLI 发布插图,来源为 官方发布文章。
哪些工作可以先用 cf
cf 的 API 命令由 schema 生成,默认输出 JSON。Workers 项目则使用 cloudflare.config.ts 配置。资源操作和项目开发都能用它,但上手方式不同:
| 你正在做什么 | 从哪里开始 | 需要检查什么 |
|---|---|---|
| 新建 Worker 项目 | cf init → cf dev → cf build | 本地路由、绑定和构建模式是否正确 |
| 管理 DNS、缓存、R2、D1 等资源 | 查询、cf schema 与 --dry-run | 账户、zone、权限和请求范围 |
| 维护已有 Wrangler 项目 | cf migrate --dry-run | 打包器选择、待办项与原有构建链 |
| 让 Coding Agent 操作 Cloudflare | 搜索命令 → 阅读 schema → 预检 | token 的作用域与真实执行条件 |
即使 Worker 继续用 Wrangler 部署,也可以先用 cf 管理 DNS 或查询资源。后面想改用 cf dev、cf deploy 时,再处理项目迁移。
安装、登录和固定版本
先检查 Node.js 版本:cf 要求 22.18 或更高版本。目前不支持 Bun 作为运行时,需要加载 cloudflare.config.ts 的命令会失败。安装后可以用 cf 或 cloudflare,它们运行的是同一个 CLI。如果 cf 这个名字已经被其他工具占用,就用 cloudflare。
npm install --global cf
cf --version

# 这些发现命令的操作不需要登录
cf cli search "create a DNS record"
cf schema dns records create
搜索命令和查看 schema 不需要登录。要读取远端资源或做实际变更,再连接账户:
cf auth login
cf auth whoami
cf zones list
即使已经登录 Wrangler,也要单独登录 cf。它优先使用 CLOUDFLARE_API_TOKEN,然后依次检查 --profile 指定的 profile、当前目录或最近父目录绑定的 profile,最后使用默认登录 profile。Global API Key 不受支持。
试用时全局安装比较方便,进入项目后最好固定版本。否则本地能跑通,CI 却下载了另一个 Beta 版本,排查起来会很费时间。已有项目完成迁移后,把验证过的版本写进开发依赖,并提交 lockfile:
# 将占位符替换为已验证的实际版本
npm install --save-dev --save-exact 'cf@<VERSION>'
npx cf --version
cf init 创建的项目已经包含 cf 依赖。安装和认证的完整说明见 官方入门文档。
不知道命令叫什么,就先搜
命令覆盖的产品多了,记住它们反而更难。cf cli search 可以用任务描述查找候选命令,比如创建 DNS 记录、创建 D1 数据库,或者清理一个 URL 的缓存。
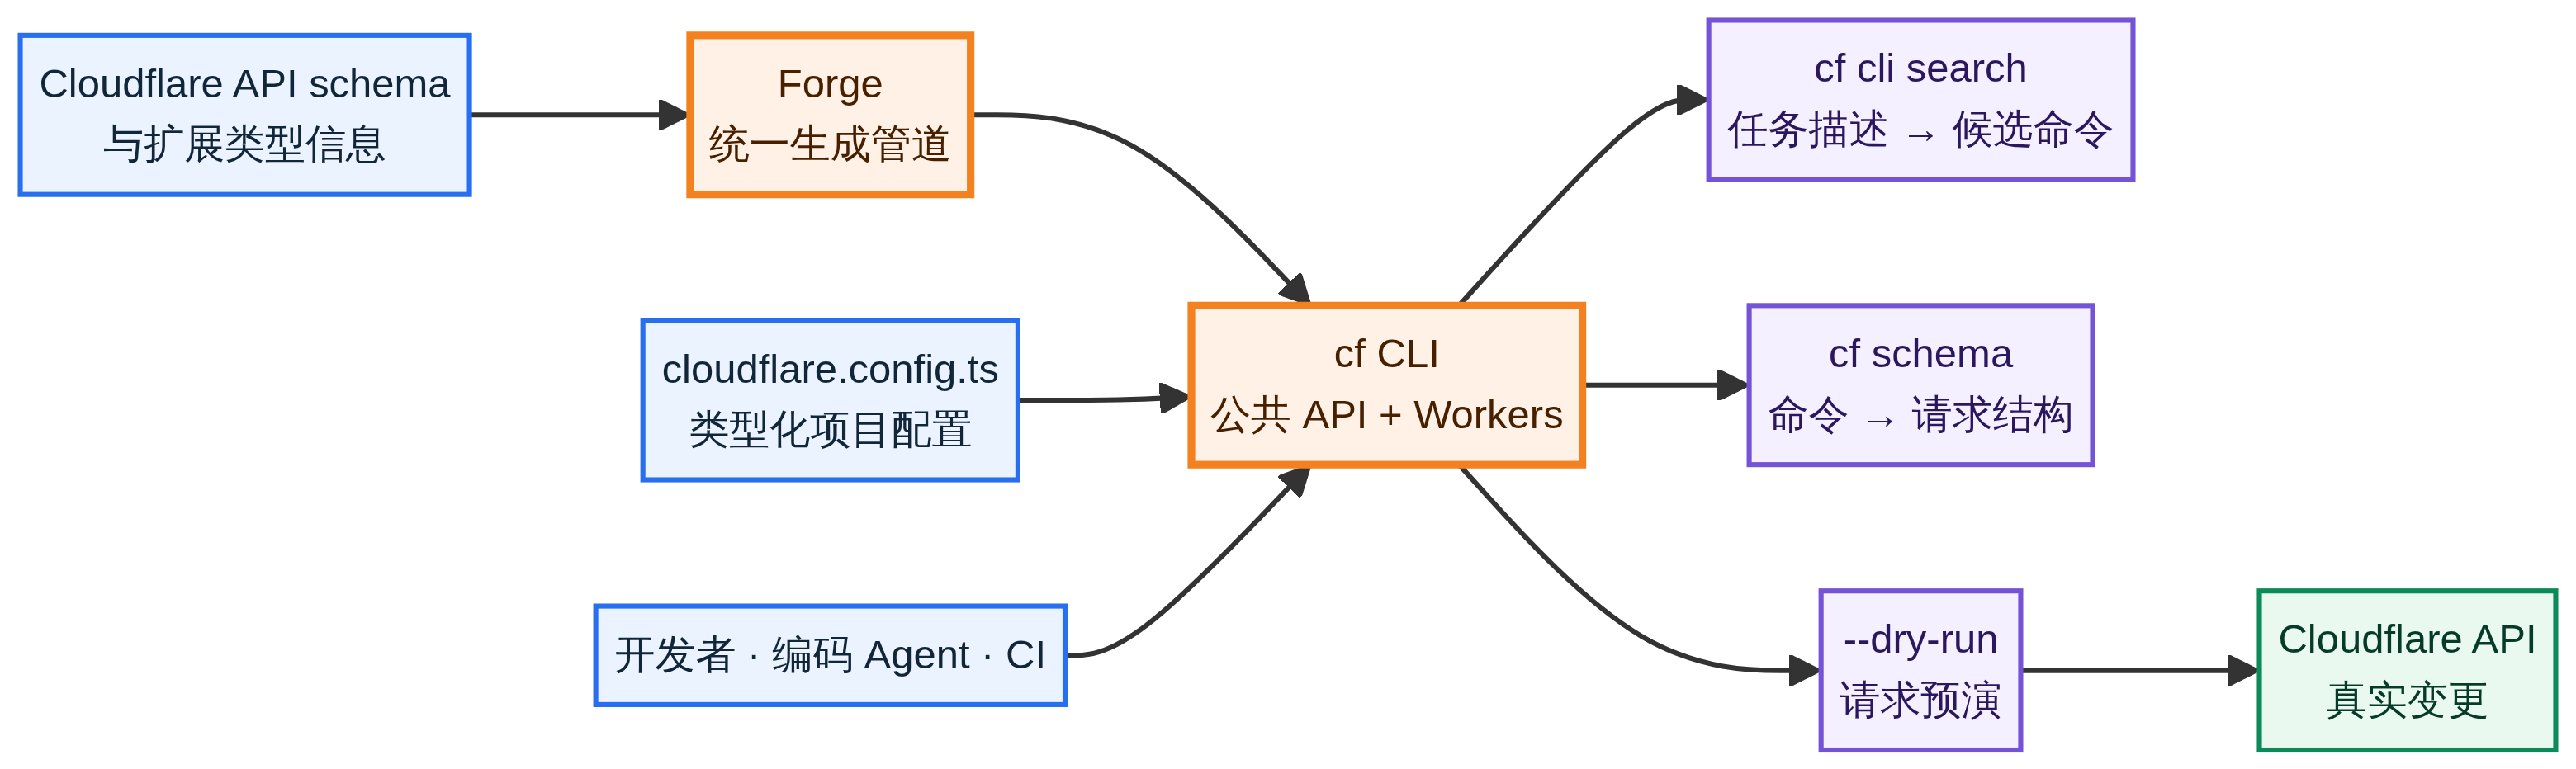
图 2:cf CLI 的命令生成与执行关系。右下角的箭头表示后续执行步骤;--dry-run 不会调用 Cloudflare API,确认后还要去掉该选项,另行执行。
cf cli search "create a DNS record"
cf cli search "create D1 database"
cf cli search "purge cached files for a URL"
搜到命令后,接着看参数:
cf schema dns records create
cf dns records create --help
cf schema 能看到生成命令的 API 请求结构,--help 能看到命令怎么调用。写脚本时,也留意输出去向:结果默认以 JSON 写到标准输出,状态和错误信息通常写到标准错误。下载文件之类的命令会直接输出原始数据,不能一律交给 JSON 解析器。
用 dry run 检查资源变更
拿 DNS 来说,知道自己要新增一条记录,还不够。记录要加到哪个 zone、指向哪个 IP、要不要开启代理,都得在执行前确定。
给生成的 API 命令加上 --dry-run,就能看到 HTTP 方法、URL、参数和请求体。这一步不发送 API 请求,也不需要凭据。它能帮你检查请求写得对不对,但远端资源是否存在、token 有没有权限,仍要在实际调用时确认。
DNS:新增一条 A 记录
cf cli search "create a DNS record"
cf schema dns records create

# 用实际 zone ID 替换占位符;此步骤不会创建记录
cf dns records create \
  --zone '<ZONE_ID>' \
  --body '{"type":"A","name":"docs","content":"192.0.2.1","proxied":true}' \
  --dry-run
这里的 192.0.2.1 是文档示例地址,实际执行前要换成源站 IP。检查预览时,把 zone 和记录名称也核对一遍。proxied: true 表示开启 Cloudflare 代理,需要结合源站访问和 TLS 设置来选。
这里有个容易忽略的区别:dry run 要传 zone ID。 正常执行时 --zone 可以接受域名,但预检不会查询域名对应的 ID。传入域名,预览就会把它直接放到路径的 ID 位置。
确认请求,并配置好相应权限的凭据后,去掉 --dry-run 执行。创建完再查一次:
cf dns records list --zone example.com --name docs.example.com这些选项的说明见 资源管理文档。
D1:创建数据库,再配置绑定
比如要给预发布环境创建 orders-staging,先看预检结果:
cf cli search "create D1 database"
cf schema d1 create
cf d1 create --name orders-staging --dry-run
名称和目标账户确认后,设置 CLOUDFLARE_API_TOKEN 与 CLOUDFLARE_ACCOUNT_ID,再执行创建:
cf d1 create --name orders-staging接下来才是 cloudflare.config.ts 里的 Worker 绑定。数据库创建成功,Worker 仍然可能绑定错。遇到问题,先查数据库,再查绑定;下面的配置例子会按环境选择数据库名称。
缓存:只清理更新过的文件
如果只更新了一个 JavaScript 文件,按 URL 清理就够了。全量清理会让其他文件也重新回源,没有必要一起清掉:
cf cli search "purge cached files for a URL"
cf schema cache purge

cf cache purge \
  --zone '<ZONE_ID>' \
  --body '{"files":["https://example.com/assets/app.js"]}' \
  --dry-run
预览会显示 POST /zones/<ZONE_ID>/purge_cache,请求体里只有这一条文件 URL。重点检查完整 URL 和文件清单,看看有没有清错环境或漏掉路径。
这些是操作示例,没有对真实账户执行。升级 Beta 版本后,重新看一次 cf schema 和 --help,确认参数有没有变化。
Workers 的 TypeScript 配置怎么用
新项目直接从独立目录开始:
cf init edge-api
cd edge-api
cf dev
在本地把路由和绑定跑通,再构建、部署。新项目默认使用 Vite,配置文件是 cloudflare.config.ts。
这个文件可以根据 mode 返回不同配置。bindings、triggers 等构建器也有类型提示,不用再靠记忆填写字段。比如让 D1 绑定跟着环境切换:
import { bindings, defineConfig } from "cf/config";

export default defineConfig(({ mode }) => ({
  worker: {
    name: "orders-api",
    compatibilityDate: "2026-09-27",
    env: {
      DB: bindings.d1({ name: `orders-${mode}` }),
    },
  },
}));
传入 --mode staging,这里选的是 orders-staging;传入 --mode production,选的是 orders-production。这段代码只展示绑定,前面创建数据库的步骤仍然要做。完整项目还需要入口和构建配置,见 程序化配置文档。
把重复的环境配置写成函数,确实省事。不过,TypeScript 配置会执行代码,也能读取环境变量、导入模块。评审时要顺着这些依赖看一遍,确认不同 mode 最后指向哪个 Worker、哪个数据库。
本地调试可以用 Local Explorer 查看支持的 KV、R2、D1 等资源。别把 --local 理解成所有 API 的离线版本:只有部分命令支持它。不支持的命令会报错,不会转去操作远端;具体范围要看当前命令文档。
老 Wrangler 项目,先看迁移结果
如果仓库里只有 wrangler.json、wrangler.jsonc 或 wrangler.toml,还没有 cloudflare.config.ts,先别运行 cf dev、cf build 或 cf deploy。这些命令可能触发自动配置,忽略已有 Wrangler 设置,也可能直接失败。起点应该是 cf migrate。
开一个功能分支,提交或暂存手头的改动,再预览迁移:
git status
cf migrate --dry-run
预览只列出准备修改的文件和后续待办,不展示生成文件的完整内容。要看具体配置,需要执行迁移后检查 diff:
cf migrate
git status
git diff
迁移后,原来的 Wrangler 配置还在,旁边会多一个 cloudflare.config.ts。工具也会把 cf 加到项目依赖中,更新 lockfile。
打包器要单独看。项目声明了 @cloudflare/vite-plugin,迁移时就选 Vite;否则选 Wrangler,并生成 wrangler.config.ts。cf migrate 不会自动安装 Vite,也不会帮你生成 vite.config.ts。如果打算换构建器,还得自己补这部分。
工具拿不准的配置会标成 TODO(@cloudflare)。存在 required 待办项时,还会加上一个 throw,让构建停下来。先处理待办,再移除这条语句。尤其是 Durable Object 绑定和迁移历史,不能只删掉 TODO 就算完成。
还有个细节:存在 required 项时,迁移或预览可能返回状态码 1。先读待办内容,别只看退出码就认定转换失败。打包器要求和待办处理方式见 官方迁移指南。
配置处理完,先跑本地开发,再验证测试环境:
cf dev
# 验证本地行为并停止开发服务器后,继续执行
cf build --mode staging
cf deploy --dry-run --mode staging
如果项目有多个环境,就逐个检查。预发布环境能构建,不代表生产环境的资源名称和路由也填对了。原有构建步骤也要跑一遍,确认之后再改生产发布流程。
让 Agent 执行时,留意凭据和退出码
Agent 可以自己搜索命令、读 schema,再把预检请求交给人看。实际执行时,顺序可以写进项目指令:
- 用
cf cli search找到候选命令。 - 阅读
cf schema与命令的--help。 - 用
--dry-run生成预检结果。 - 核对账户、zone、请求体和允许的变更范围。
- 使用受限凭据执行,再查询实际状态。
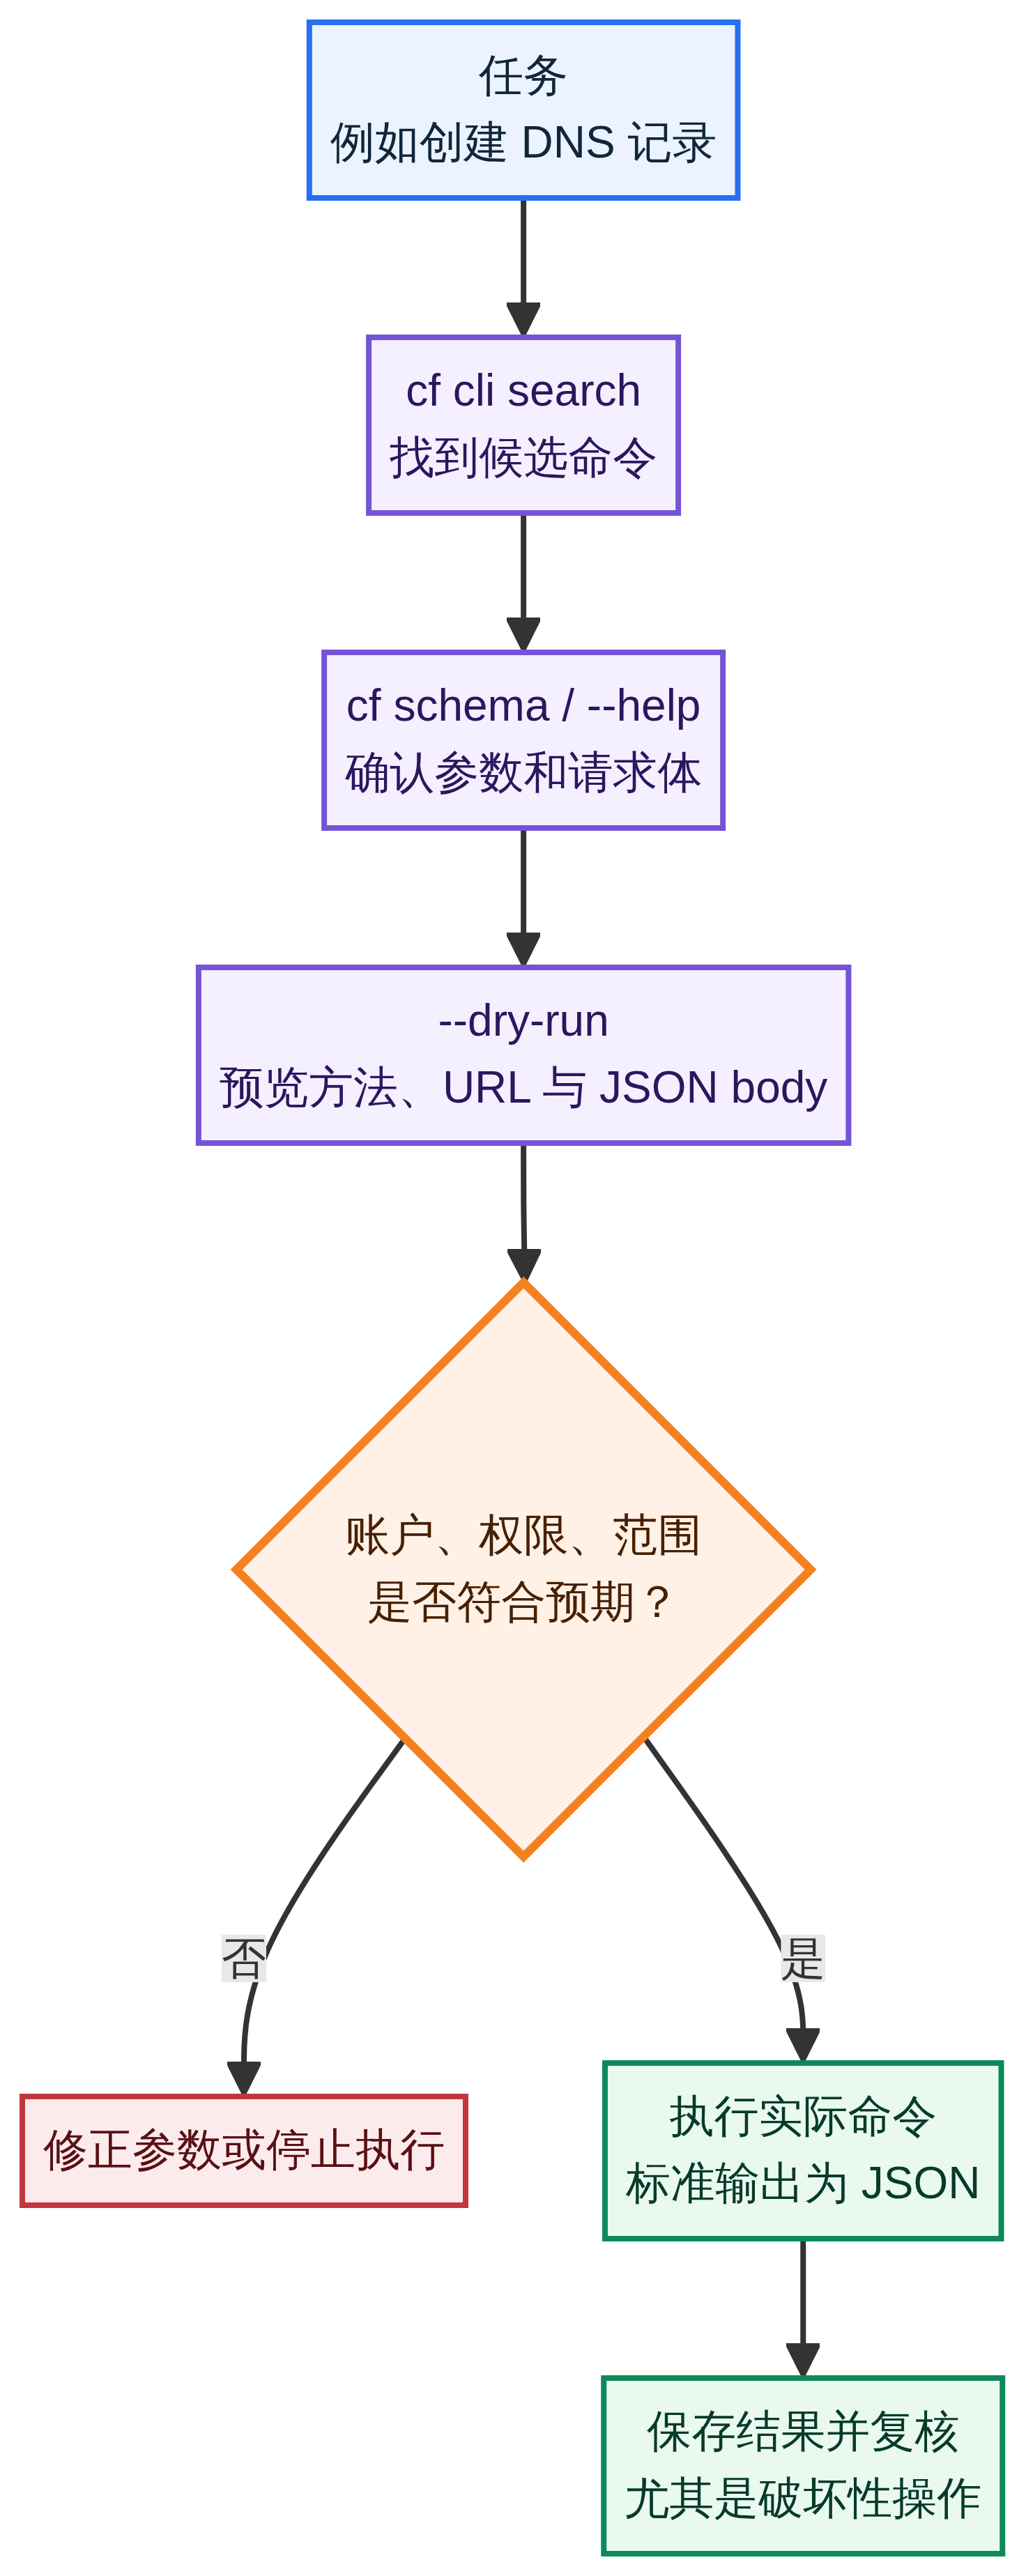
图 3:Cloudflare 变更的检查顺序。预检通过后,确认是否允许执行;执行完再查询实际状态。
个人账户和工作账户可以用不同 profile。无人值守的 Agent 或 CI 使用 API token,只给它任务需要的权限。即使项目指令写了要先审核,凭据本身也应该限制它能操作的资源。
写自动化脚本时,有个地方很容易踩坑:非交互环境里的破坏性命令,没有 --force 时可能打印 Aborted.,什么也没改,却返回状态码 0。 流水线会显示成功,但资源还在。除了检查标准错误,执行后最好再查一次资源状态。
也别为了让脚本继续跑,就给所有命令加上 --force。它在某些命令中同时是 API 行为参数,可能改变操作范围。先看该命令的帮助,具体规则见 编码 Agent 文档。
CI 里不要重新构建一次
PR 阶段只构建和预检,不给生产 token。到部署步骤,用 --prebuilt 上传前面检查过的产物:
# PR 和其他分支:构建与预检,不上传或调用 Cloudflare API
npx cf build --mode production
npx cf deploy --prebuilt --mode production --dry-run

# 受保护的部署步骤:提供凭据并部署同一份产物
npx cf deploy --prebuilt --mode production
--prebuilt 会跳过构建,使用已有 Build Output。这里两个步骤都用了 --mode production;模式不一致,部署会在上传前停止。如果构建和部署拆成不同 CI 作业,要把 .cloudflare/output 一起传过去,否则部署作业拿不到产物。
CLOUDFLARE_API_TOKEN 和 CLOUDFLARE_ACCOUNT_ID 只放到最终部署步骤。构建和预检不调用 Cloudflare API,不过安装依赖、自定义构建脚本仍可能访问网络。CI 的完整示例见 官方文档。
至于老项目什么时候迁移,我会把条件定得具体一点:迁移 TODO 都处理完,各环境的构建和预检通过,测试环境的实际部署也验证过,再改生产 CI。Wrangler 项目正在稳定运行,就先沿用现有部署方式,平时用 cf 查资源、检查 API 请求,也能省下不少翻文档的时间。
参考资料
Mttao GitHub ↗
探索技术与生活的智慧